benchmark
A LanceDB DuckDB-integrációval és 1,5 millió IOPS-szal erősít
A LanceDB DuckDB-kiterjesztése SQL-alapú vektoros, teljes szöveges és hibrid keresést tesz lehetővé Lance-adathalmazokon. A vállalat emellett több S3-bucketet átfogó…
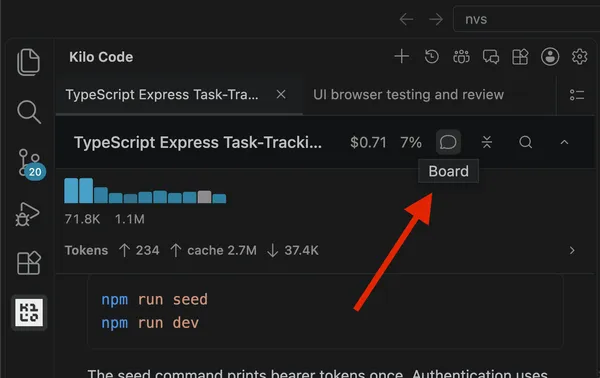
A Kilo Swarm 39 százalékkal csökkentette a költséget egy célfeladaton
A Kilo Swarm egy összetett, több ügynökkel végzett fejlesztési feladaton 39,2 százalékkal csökkentette a költséget, miközben a teszt mind a tíz futása sikeres lett. A…
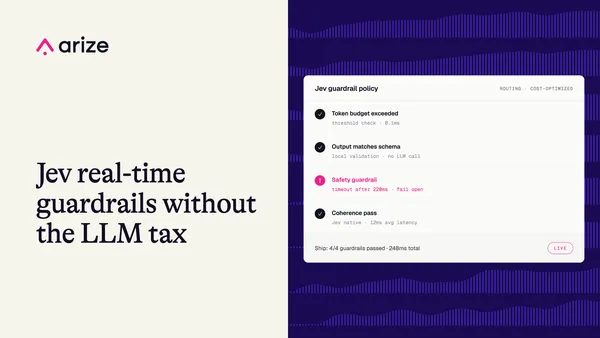
A Jev gyorsabban szűri ki az LLM-ek veszélyes döntéseit
Az Arize AI összehasonlította a TypeSafe Jev döntési modelljét és az OpenAI GPT-5.4 nano modelljét egy autókereskedői chatbot védelmében. A Jev a bemutatóban 15-18-szor…
Az NVIDIA tesztje szerint sok kódolóügynök elbukik éles kiszolgálásban
Az NVIDIA új SWE-Serve benchmarkja azt vizsgálja, hogy az AI-kódolóügynökök javításai működnek-e valódi modellkiszolgálás közben. A 19, éles szervert indító feladatnál a…
A Snorkel szerint az Opus 5.5 vezet a kódolási tesztben
Az Opus 5.5 érte el a legmagasabb összesített sikerarányt a Snorkel AI szakértők által összeállított kódolási feladatsorán. A modell 68 százalékos eredményt ért el…
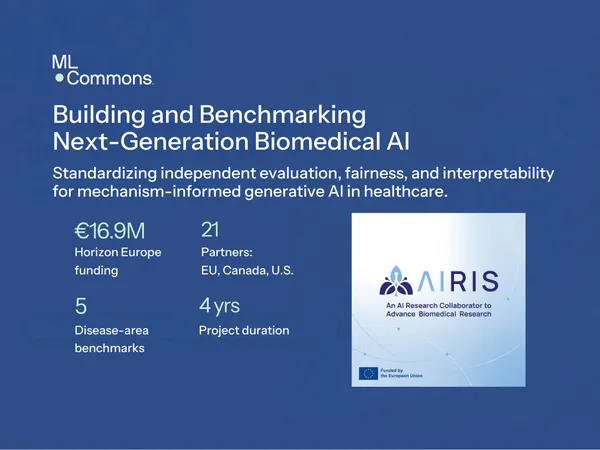
Az MLCommons az AIRIS projektben méri majd az orvosi AI megbízhatóságát
Az MLCommons csatlakozott az uniós finanszírozású AIRIS kutatási projekthez, amely biológiai ismereteket és klinikai adatokat integráló generatív AI-modelleket fejleszt.…
Az SAP vezető lett a Gartner munkaerő-menedzsment rangsorában
Az SAP vezetőként szerepel a Gartner első, Workforce Management Technology témájú Magic Quadrant jelentésében. A vállalat szerint a minősítés a munkaerő-műveleteket, az…
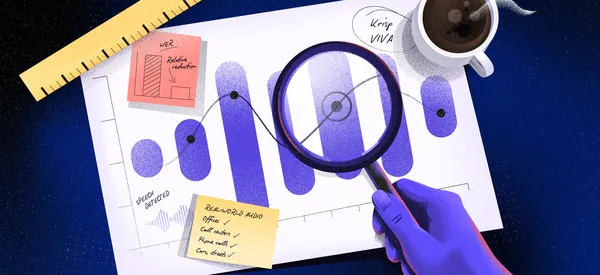
A beszédfelismerők még elbuknak, ha más is beszél a háttérben
A modern beszédfelismerők jól kezelik a forgalom, a légkondicionáló és a billentyűzet zaját, de egy másik beszélő hangja továbbra is komoly hibákat okoz. A Krisp 265…
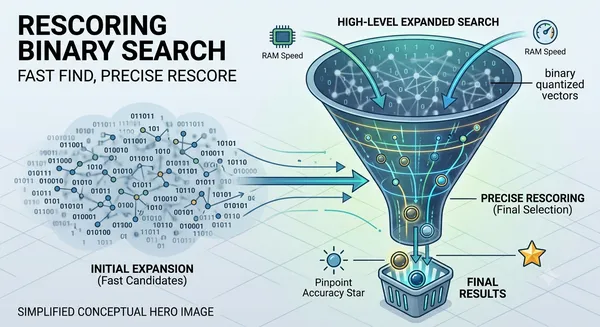
Kevesebb memóriával gyorsabb vektorkeresést ígér a Neo4j új megoldása
A Neo4j 2026.09 verziója alapértelmezetté teszi az újonnan létrehozott vektorindexeknél az újraértékelt bináris kvantálást. A cég szerint a módszer jelentősen csökkenti…
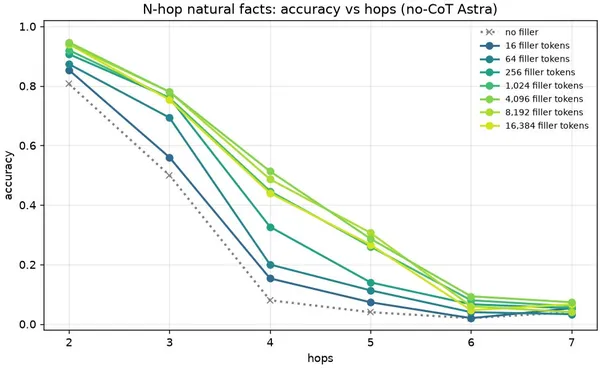
A filler tokenekkel sokkal jobban teljesít a GPT-6-Astra
A GPT-6-Astra jelentősen jobban teljesít több feladaton, ha a kérdéshez értelmetlen filler tokeneket, például pontokat illesztenek, miközben a modellnek azonnal kell…
Az Apple módszere 128-szor gyorsabb szöveggenerálást ígér
Az Apple kutatói bemutatták az FS-DFM nevű módszert, amely kevés lépéssel gyorsítja fel a diffúziós nyelvi modellek szöveggenerálását. A vállalat szerint a rendszer…
A Factory Router 63 százalékkal csökkentette a következtetés költségét
A Factory Router produkciós használat mellett összesítve 63 százalékkal csökkentette a következtetés költségét a közzétett frontier modellárakhoz képest. A rendszer a…
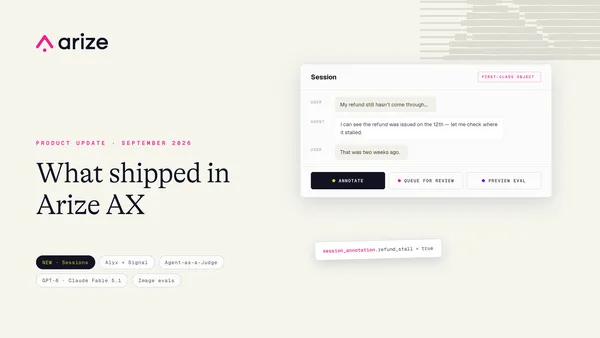
Az Arize AX minden csomagban elérhetővé tette az Agent-as-a-Judge funkciót
Az Arize AX szeptemberi frissítései a teljes beszélgetéseket önálló munkafolyamattá emelik, és minden csomagban elérhetővé teszik az Agent-as-a-Judge értékelőt. A…
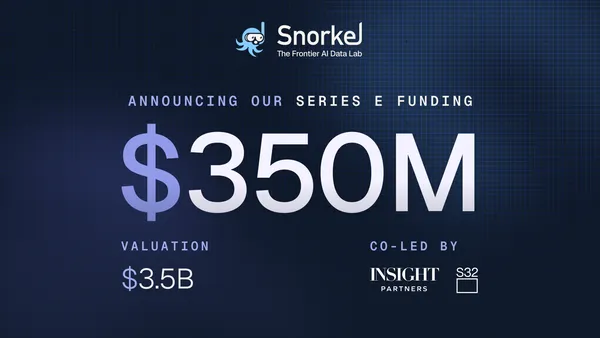
350 millió dollárt vont be az AI-adatokra építő Snorkel AI
A Snorkel AI 350 millió dolláros Series E finanszírozást vont be 3,5 milliárd dolláros értékelés mellett. A vállalat kutatási laboratóriumot építene az AI-rendszerek…
A Grok 4.7 olcsóbban hozza az Opus 4.8 szintjét kódolásban
A Grok 4.7 a Senior SWE-Bench teszten 40,0 százalékos tasteful pass@3 eredményt ért el, ezzel holtversenyben hatodik lett. Az eredmény megegyezik az Opus 4.8…
Az UK AISI nyilvánosabbá teszi az MI-modellek teszteredményeit
Az Egyesült Királyság AI Security Institute-ja az EvalEval infrastruktúráját használja az MI-modellek értékelési eredményeinek nyilvános megosztására. A kezdeményezés…
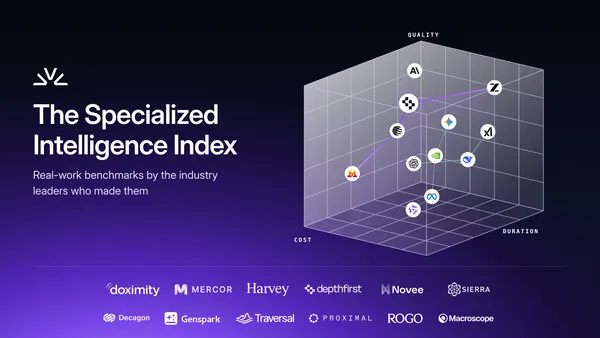
A Fireworks AI elindította a valós munkát mérő modellindexet
A Fireworks AI elindította a Specialized Intelligence Indexet, amely iparág-specifikus, gyakorlati feladatokon méri a nyílt, zárt és specializált AI-modellek…
A Jev gyorsabb és olcsóbb, de kevésbé pontos a Claude Opus 5-nél
A Jev 1.13 a Banking77 szándékfelismerési tesztjén 81,0 százalékos pontosságot ért el, a Claude Opus 5 pedig 84,4 százalékot. Az OpenRouter mérése szerint a Jev medián…
KutatásA Jev kiválthatja az LLM-es bírákat? Az MLflow tesztelte
A TypeSafe Jev modellje 30 MLflow-val kapcsolatos kérdés mindegyikén egyezett az emberi értékeléssel, miközben a tesztben ez volt a leggyorsabb és legolcsóbb bíró. A…
A Claude Opus 5.5 több hibát találhat, de több megjegyzést is generál
A Claude Opus 5.5 a CodeRabbit tesztjeiben kissé több ismert hibát talált a vállalat éles modellmixénél, miközben alacsonyabb műveleti pontosságot és több megjegyzést…
Akár 95 százalékkal is csökkenthető az AI tokenköltsége az Alteryx szerint
Az Alteryx és partnere, a NextWave egymástól független tokenfogyasztási benchmarkokat végzett. A vállalat szerint a megfelelő üzleti logika, munkafolyamatok és…
Az Alteryx szerint akár 95 százalékkal csökkenthető az AI tokenköltsége
Az Alteryx és partnere, a NextWave tesztjei szerint az előzetes adatfeldolgozás, a rögzített üzleti logika és a megfelelő modellválasztás jelentősen csökkentheti a nagy…
Az NVIDIA szerint így érdemes mérni az AI-ügynökök valódi teljesítményét
Az AI-ügynökök értékelésénél az NVIDIA Developer szerint már nem elég azt nézni, hogy egy modell helyesen hív-e meg egy eszközt. A lényeg az, hogy a több lépésből álló…
Az AI gyorsabban fejlődik, mint ahogy az emberek tesztelni tudják
A frontier AI-modellek képességei gyorsabban nőnek, mint ahogy a fejlesztők és a hatóságok tesztelni, értelmezni és ellenőrizni tudják őket. Az Atlantic Council szerint…