benchmark
A Replit Agent maga dönti el, mikor és melyik modellt használja
A Replit Agent új vezérlési rendszere a fő modellre bízza, mennyire gondolja végig a feladatot, mikor delegál részfeladatot, és melyik almodellt választja hozzá. A…
Az Anthropic csökkentette Claude jellegzetes fordulatait, de nem tűntek el
Az Opus 5.5 valóban szinte teljesen elhagyta a hosszú gondolatjeleket, és a Claude-ra jellemző stiláris fordulatok száma is csökkent. Az Arize AI vizsgálata szerint…
Az Anthropic tényleg javított Claude stílusán, de nem tüntette el teljesen
Az Opus 5.5 valóban sokkal kevesebb em dash jelet és Claude-ra jellemző fordulatot használ, mint az Opus 5, de az Arize AI vizsgálata szerint a probléma nem tűnt el…
Az Apple szerint a nyelvi modellek kommunikációja veszteséges
Az Apple kutatása szerint a nyelvi modellek természetes nyelven folytatott kommunikációja jelentős információveszteséggel jár, amikor fa struktúrájú adatokat kell…

A Red Hat szerint a Kubernetes és a CPU-k is erősek AI-inferencia alatt
A Red Hat az MLPerf Inference v6.1 tesztjeiben magas teljesítményt ért el Kubernetes-alapú GPU-s rendszereken, miközben CPU-only konfigurációkon is erős eredményeket…
Az Apple szerint a nyelvi modellek kommunikációja veszteséges
Az Apple kutatói azt vizsgálták, mennyire marad meg a fastruktúrájú információ, amikor a nyelvi modellek természetes nyelven adják tovább egymásnak. Eredményeik szerint…
A Red Hat szerint a Kubernetes és a CPU-k is jól teljesítettek az MLPerfben
A Red Hat közzétette az MLPerf Inference v6.1 benchmarkban elért eredményeit. A vállalat szerint az OpenShift és a vLLM Kubernetes-alapú környezetben is versenyképes…
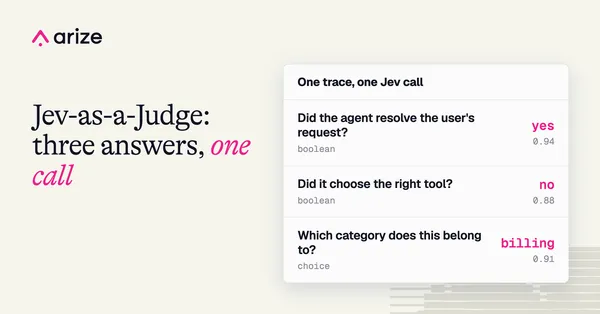
Jev-as-a-Judge értékelés érkezett az Arize AX platformra
Az Arize AX közvetlenül integrálta a TypeSafe AI Jev döntési modelljét, így a csapatok natív módon értékelhetik a gyártási nyomokat. A Jev-as-a-Judge strukturált…
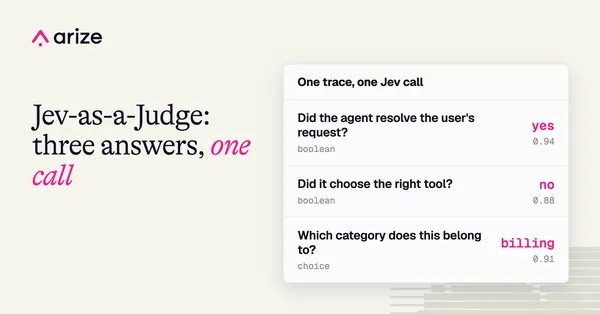
Az Arize AX közvetlenül támogatja a Jev-as-a-Judge értékeléseket
Az Arize AX natív integrációt kapott a TypeSafe AI Jev rendszerével, így a csapatok közvetlenül a platformon értékelhetik a gyártásból származó nyomkövetéseket. A Jev…
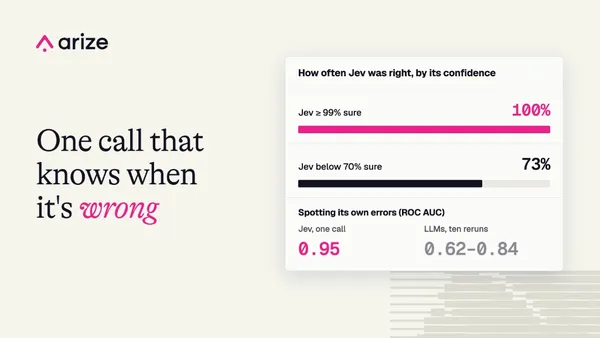
A Jev valószínűségei olyan hibákat is jeleznek, amelyeket az LLM-ek elrejtenek
A Jev címkénkénti valószínűségei megbízhatóan jelezték, mikor tévedett az értékelésben, miközben az ismételten futtatott nyelvi modellek sok hibás döntésnél…
265 valódi beszélgetéssel teszteli a háttérhangok felismerését a Krisp
A Krisp 265 valódi beszélgetésből álló tesztadatbázist készített a háttérben megszólaló hangok vizsgálatára. A felvételek irodákban, call centerekben és mozgó autókban…
A LangChain Jevvel építene gyorsabb és olcsóbb AI-ügynököket
A LangChain bemutatta, hogyan használható együtt a TypeSafe Jev döntési modellje és a LangGraph az AI-ügynökök megbízhatóbb működtetésére. A vállalat szerint Jev a szűk…
A LangChain Jevvel építene gyorsabb és olcsóbb AI-ügynököket
A LangChain bemutatta, hogyan használható együtt a TypeSafe döntési modellje, a Jev és a LangGraph éles környezetbe szánt AI-ügynökökben. A megközelítésben a kód…
A Claude Sonnet 5.5 több hibát talált, feleannyi idő alatt
A CodeRabbit tesztjeiben a Claude Sonnet 5.5 több ismert hibát talált meg a Sonnet 5-nél, miközben körülbelül feleannyi idő alatt futott le. A javulás ára az, hogy a…
A Scale AI szerint Washingtonnak saját AI-tesztelési kapacitás kell
A Scale AI szerint az amerikai szövetségi kormány nem tudja megfelelően mérni a legfejlettebb mesterségesintelligencia-modellek kockázatait, ezért független tesztelési…
Rustban írták újra a cross-encoder inferenciát, de nem mindenhol lett gyorsabb
A Qdrant Rustban írta újra a cross-encoder modellek futtatását, majd Python-alapú könyvtárakkal hasonlította össze. A cross-encode-rs kis modellen csak mérsékelten…
KutatásAz MLflow tesztjén a Jev gyors volt, de hibákat is átengedett
A Jev strukturált döntési modell az MLflow új tesztjén 72 válaszból 64 esetben egyezett az emberi címkézéssel. A modell gyorsabb és olcsóbb volt a GPT-OSS-120B-nél, de…
A dbt Semantic Layer megbízhatóbb válaszokat adott az AI-ügynököknek
A dbt Semantic Layer bizonyult a legmegbízhatóbb és legolcsóbb interfésznek egy Fivetran által végzett tesztben, amelyben két AI-modell ugyanazokra az üzleti kérdésekre…
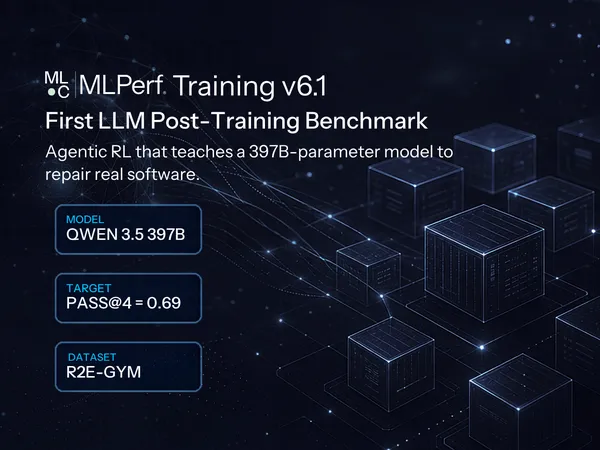
Az MLPerf új benchmarkkal méri a nagy nyelvi modellek utótréningjét
Az MLPerf Training első alkalommal külön benchmarkkal méri a nagy nyelvi modellek utótréningjét. A teszt a Qwen 3.5 397B modellt szoftverfejlesztési feladatokon…
A GPT-5.6 Sol vezeti a régi rendszerekre szabott tesztet
A GPT-5.6 Sol érte el a legjobb eredményt a Factory Legacy-Bench nevű tesztjén, amely a COBOL, a Java 7, a BASIC, a C89, a Fortran és az Assembly kezelését vizsgálja. A…
A Quail több mint egymilliárd tokent dolgoz fel percenként H100-on
A Modal bemutatta a Quail nevű következtetési motort, amelyet kifejezetten AI-SQL munkafolyamatokra terveztek. A vállalat szerint egy H100 GPU-n több mint egymilliárd…
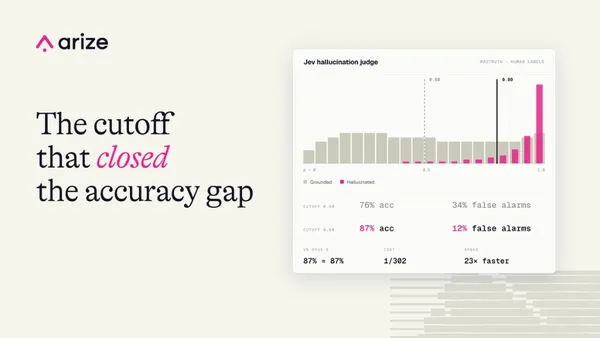
Az Arize szerint a Jev 300-szor olcsóbban érte el Claude Opus 5 pontosságát
A Jev a Claude Opus 5-tel azonos, 87 százalékos pontosságot ért el az Arize hallucination detection tesztjén, miközben a vállalat szerint körülbelül 300-szor olcsóbb és…
A LanceDB 10 milliárd vektoros keresést mutatott be
A LanceDB olyan vektorkeresési architektúrát mutatott be, amely 10 millió vektortól 10 milliárd vektorig támogatja a keresést. A vállalat szerint a rendszer elosztott…
LanceDB új világmodell-platformot és multimodális SQL-eszközt mutatott be
A LanceDB három új fejlesztést emelt ki legutóbbi hírlevelében: egy Lance-alapú, reprodukálható világmodell-kutatási platformot, a DuckDB multimodális SQL-integrációját…