benchmark
A LangChain szerint a Jev pontosabb és olcsóbb agentértékelő lehet
A LangChain tesztje szerint a TypeSafe AI Jev modellje stabilabb eredményeket adott agentek értékelésekor, mint a vizsgált nagy nyelvi modellek. A rendszer 0,44…
100 vezetői helyezést szerzett az SAP Customer Experience a G2 rangsorain
Több mint 100 vezetői helyezést szerzett az SAP Customer Experience a G2 2026-os őszi Grid Reports jelentéseiben. A rangsorok kizárólag ellenőrzött ügyfélértékelésekre…
Termékek és eszközökA V7 78 százalékkal csökkentette költségeit a GPT-5.6 Lunával
A V7 Go a GPT-5.6 Luna használatával 78 százalékkal alacsonyabb dokumentumonkénti költséget mért, mint a GPT-5.4 mini esetében. Az OpenAI által közölt esettanulmány…
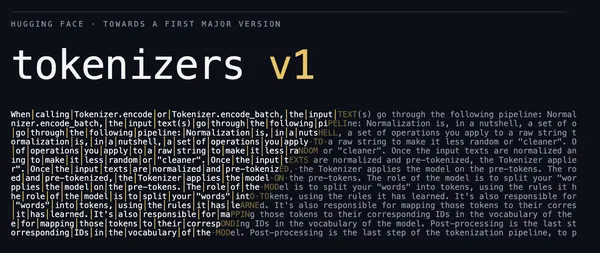
A Hugging Face új tokenizálója akár tízszer gyorsabb lehet
A Hugging Face bemutatta a tokenizers v1 kiadásjelölt változatának teljesítménytesztjeit. A fejlesztők szerint az új verzió a v0.23-hoz képest sok esetben tízszeres…
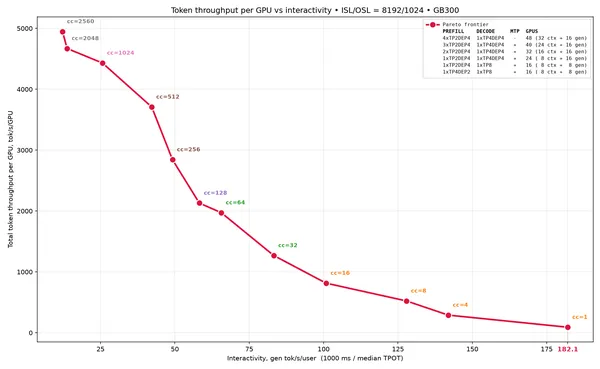
A vLLM 5000 tokent ért el GPU-nként a Qwen3.8-2.4T kiszolgálásában
A vLLM közzétette a Qwen3.8-2.4T modell szétválasztott előfeldolgozás és dekódolás alapú kiszolgálásának eredményeit. A GB300 NVL72 fürtön végzett mérésben nagy…
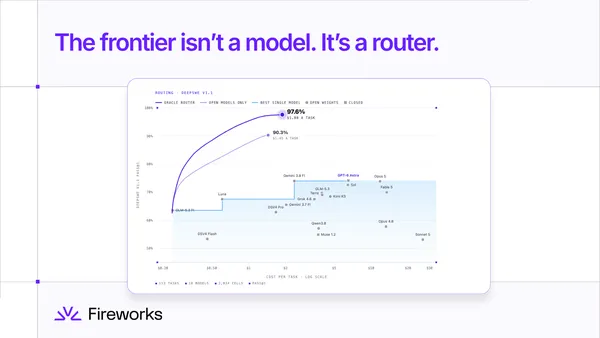
A Fireworks szerint a modellek együtt többre képesek, mint külön-külön
A megfelelő modell feladatonkénti kiválasztásával jelentősen javítható egy kódoló ügynök teljesítménye, miközben a költség is csökkenthető. A Fireworks AI elemzése…
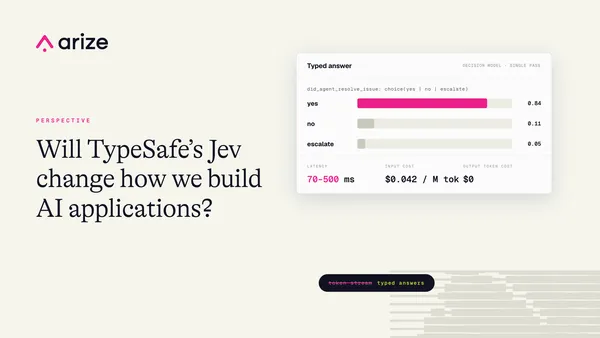
A TypeSafe Jev döntéseket hoz, de egyetlen mondatot sem ír
A TypeSafe Jev olyan modell, amely osztályoz, pontoz és útvonalat választ, de nem generál szabad szöveget. A cég mérései szerint bizonyos feladatokon akár 200-szor…
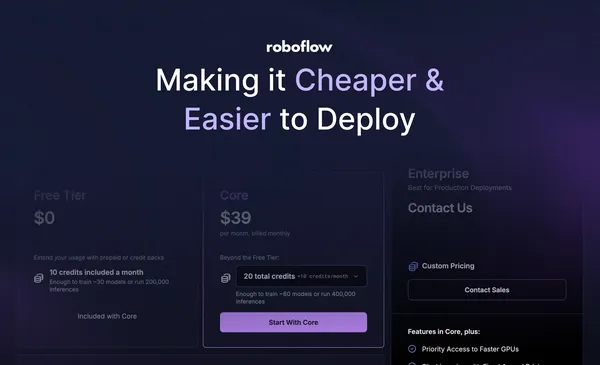
Olcsóbbá és kiszámíthatóbbá teszi a telepítést a Roboflow
A Roboflow olcsóbb, képenkénti díjazásra állítja át Serverless API-ját, ingyenes szinttel bővíti Core csomagját, és megszünteti a helyi inference kreditalapú díját. A…
Az NVIDIA bemutatta az AIPerfet, amely nagy terhelésű LLM-mérésekre készült
Az NVIDIA AIPerf a GenAI-Perf utódjaként érkezik, és olyan nagy terhelésű nyelvimodell-mérésekhez készült, amelyeknél maga a tesztelő kliens sem válhat szűk…
A Roboflow szerint a GPT-6 Astra a legerősebb látásmodell
A Roboflow tesztjei alapján a GPT-6 Astra eddig a legerősebb látásmodell, amelyet a vállalat vizsgált. A modell objektumfelismerésben, számlálásban és vizuális…
Az OpenRouter összevetette 20 képgeneráló modell költségeit
Az OpenRouter 20 képgeneráló modell költségét, kimeneti formátumát és támogatott beállításait vetette össze azonos tesztfeltételek mellett. A legolcsóbb mérésben az…
A Roboflow szerint a GPT-6 Astra objektumokat is képes körberajzolni
A GPT-6 Astra képes azonosított objektumok körvonalát poligonként visszaadni, derül ki a Roboflow tesztjéből. A módszer számoláshoz, kivágáshoz és címkézéshez…
Az Arize AI új módszerrel keresné az ügynökök rejtett hibáit
A produkcióban futó AI-ügynökök olyan hibákat is elkövethetnek, amelyekre a fejlesztők előre nem készítettek tesztet. Az Arize AI Signal nevű rendszere a futási nyomok…
AI-ügynök értékeli, mennyire jól szerkesztenek képeket az új modellek
A Lambda, a Texasi Egyetem austini kampuszával, a UCLA-val és a Microsofttal közösen, EdiVal-Agent néven olyan keretrendszert fejlesztett, amely AI-ügynökkel értékeli a…
Rekordszámú résztvevővel érkezett az MLPerf Inference v6.1
Az MLPerf Inference v6.1 minden korábbinál szélesebb mezőnyt hozott, 30 szervezet összesen 120 rendszert nevezett. A szeptember 17-i elemzés szerint a fordulóban az…
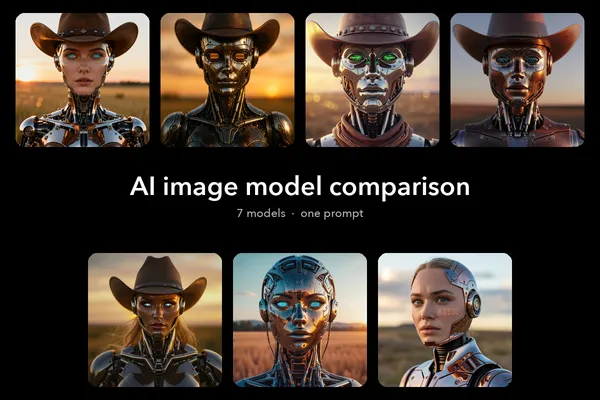
A Picsart tesztjén a Seedream 4.0 követte legpontosabban a promptot
A Seedream 4.0 bizonyult a Picsart összehasonlításában a legpontosabb képgeneráló modellnek. A tesztben hét rendszer ugyanazt a részletes robotcowgirl-promptot kapta…
A beállítások többet számítanak, mint a helyi LLM-szerverek neve
A Mozilla.ai négy népszerű helyi LLM-szervert hasonlított össze Mac Studio M4-en, NVIDIA L40S-en és Steam Decken. A mérések szerint a teljesítményt sok esetben inkább a…
A Vercel Sandboxban is futtathatók a Harbor értékelései
A Vercel Sandbox támogatja a Harbor nyílt forráskódú értékelési keretrendszerét, így a Terminal-Bench és több más benchmark is futtatható a Vercel infrastruktúráján. Az…
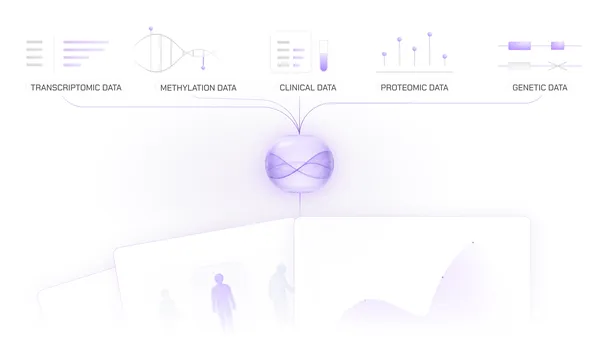
A Liquid AI kis modellekkel vizsgálná az öregedés biológiáját
A Liquid AI bemutatta a LongevityBench tesztkészletet, amely nyelvi modelleket vizsgál öregedéshez és hosszú élettartamhoz kapcsolódó biológiai adatokon. A vállalat…
Harvard benchmark méri, képes-e egy AI robotot tervezni
A Harvard és a Georgia Tech kutatói bemutatták az RLE-Bench nevű nyílt forráskódú tesztet, amely azt vizsgálja, hogy az AI-kódoló ügynökök képesek-e fizikai robotok…
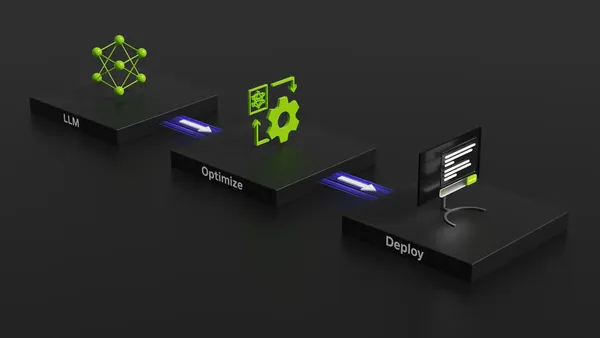
A Jetson AGX Thoron 6,4-szer gyorsabban futott az agentikus teszt
Az NVIDIA TensorRT Edge-LLM 24 perc 36 másodperc alatt futtatta le az MLPerf Inference v6.1 Edge Agentic benchmark teljesítménytesztjét egyetlen Jetson AGX Thor…
Az MLPerfben először mértek adatközponti AI-ügynököt
Az MLPerf Inference v6.1 mérésében először szerepelt adatközponti hardveren futtatott ügynöki terhelés, a Lambda pedig egy ezermilliárdnál több paraméteres modellt…
Az NVIDIA Vera Rubin NVL72 akár 3,7-szer gyorsabb a GB300-nál
Az NVIDIA Vera Rubin NVL72 rendszerének első MLPerf Inference szereplése jelentős teljesítményelőnyt mutatott a GB300 NVL72-höz képest. A vállalat szerint Qwen3-VL alatt…
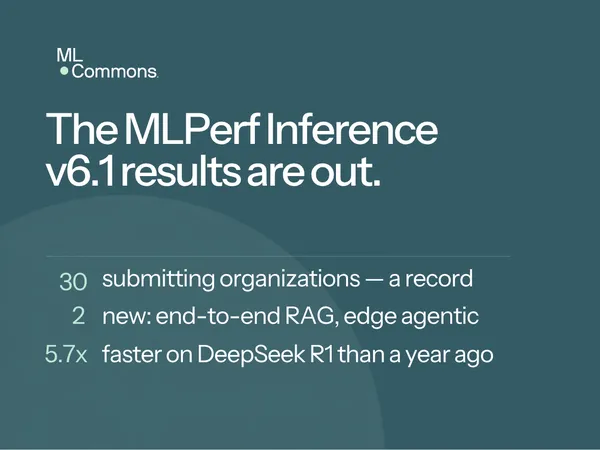
Rekordszámú résztvevővel érkezett az MLPerf Inference v6.1
Az MLCommons közzétette az MLPerf Inference v6.1 eredményeit, amelyekben rekordszámú, 30 szervezet vett részt. A kiadás két új tesztet vezetett be, és egyes feladatokban…