benchmark
Az Ai2 új módszere megmutatná, mit mérnek valójában az LLM-tesztek
Az Ai2 2026. szeptember 1-jén bemutatta a BenchMIRT nevű módszert, amellyel az LLM-benchmarkokat az egyes kérdések és feladatok szintjén lehet auditálni. A cél annak…
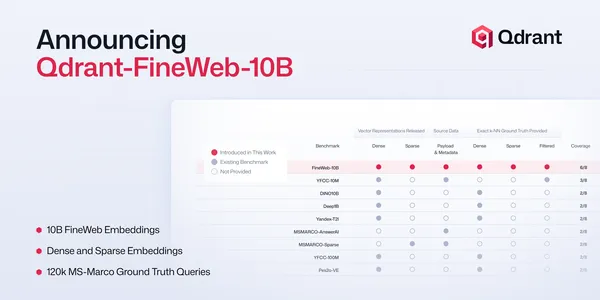
A Qdrant 10 milliárd vektoros benchmarkot és nyílt eszközöket ad ki
A Qdrant bemutatta a Qdrant-FineWeb-10B nevű, 10 milliárd vektort tartalmazó nyílt benchmarkot, valamint a hozzá készített Supernova keretrendszert. A vállalat szerint…
A CodeRabbit szerint a Fable 5.1 pontosabban, de lassabban review-zik
A Fable 5.1 a CodeRabbit tesztjeiben kevesebb és pontosabb kódreview-megjegyzést készített, mint a Fable 5, viszont egy feladat ellenőrzése átlagosan több időt vett…
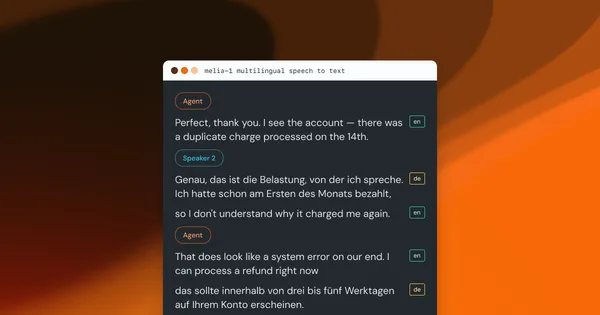
A Speechmatics Melia 1 modellje javította a többnyelvű átírást
A Speechmatics szerint Melia 1 beszédfelismerő modellje vezeti a tesztelt rendszerek mezőnyét az arab, mandarin és tamil nyelv közötti váltások felismerésében. Arab és…
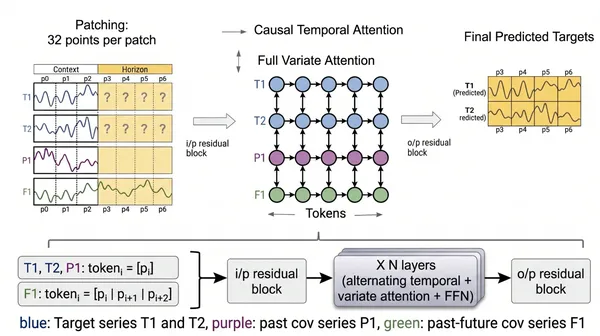
A Google bemutatta a TimesFM-3 idősoros előrejelző modellt
A Google Research 2026. augusztus 31-én bemutatta a TimesFM-3 modellt, a TimesFM idősoros alapmodell-család új generációját. A cég szerint a modell többváltozós…
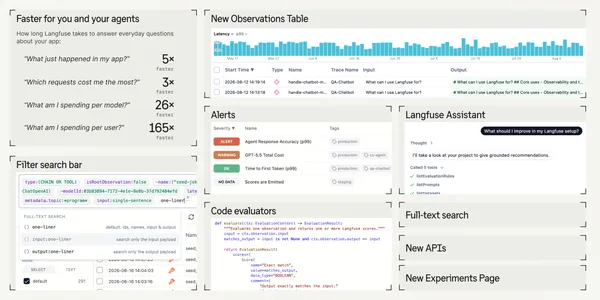
Megjelent a Langfuse v4, gyorsabb értékeléssel és multimodális támogatással
A Langfuse kiadta a Langfuse v4-et, új értékelőbeállítási folyamatot vezetett be, és kép-, hang-, videó- és PDF-tartalmak elemzésére is alkalmassá tette az értékelőket.…
Öt Context7-alternatíva, ha a kódolási ügynök többre képes
A Context7 friss könyvtárdokumentációt ad a kódolási ügynököknek, de a GitHub-repók, issue-k és pull requestek keresésében korlátozott. A Firecrawl DevDex benchmarkje…
Négy AI-videóeszközt teszteltek, eltérően követik a promptokat
A Higgsfield összehasonlítása szerint nincs egyetlen AI-videóeszköz, amely minden promptkövetési kategóriában a legjobb lenne. A Cinema Studio 4.0 a legtöbb megadott…
A Terminal-Bench 4.0 folyamatos ellenőrzéssel tartaná értékét
Megjelent a Terminal-Bench 4.0, amely a feladatok szigorúbb ellenőrzésére, a reprodukálhatóságra és a benchmark folyamatos karbantartására épít. A Snorkel AI szerint a…
Global South nyelv került az Open ASR Leaderboardra
A Hugging Face 2026. augusztus 28-án közölte, hogy az Open ASR Leaderboard felvette első Global South nyelvét. A bejelentés az automatikus beszédfelismerési rendszerek…
A GLM-5.3 Flash olcsóbban hozza a teljes modell teljesítményének nagy részét
A GLM-5.3 Flash a DeepSWE szoftverfejlesztési benchmarkon első próbálkozásra gyengébb volt a teljes GLM-5.3-nál, ismételt futtatásokkal azonban jelentősen csökkent a…
A Roboflow Playgroundban 134 számítógépes látásmodellt lehet összevetni
A Roboflow Playground ugyanazt a képet és promptot akár öt, összesen 134 támogatott számítógépes látásmodellnek adja át párhuzamosan. Az ingyenes környezetben többek…
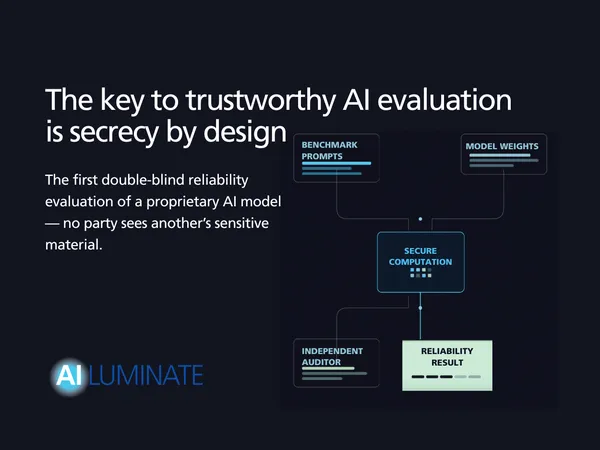
Titkosítással védené az AI-tesztek és modellek integritását az MLCommons
Első alkalommal teszteltek kettős vak módszerrel zárt súlyú AI-modellt úgy, hogy a folyamatban részt vevő felek ne férjenek hozzá egymás érzékeny adataihoz. Az MLCommons…
Biztonság és etikaKettős vak AI-értékelést indít a Google DeepMind külső partnerekkel
A Google DeepMind 2026. augusztus 27-én bejelentette, hogy elindítja a világ első kettős vak értékelését egy saját, frontier kategóriájú AI-modellen. A pilotban a…
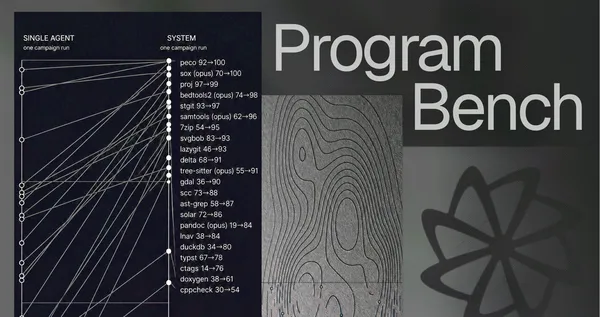
A külön szerepekre bontott AI-rendszer sokkal több kódot fedett le
A Factory Research vizsgálata szerint a nagy szoftveres feladatoknál jelentősen javíthatja az eredményt, ha a kódoló ügynök mellett külön szerep felel a teljesítés…
A DeepSeek V4 Flash 12 centből ért el IMO-aranyszintet
A DeepSeek V4 Flash 30 pontot szerzett az IMO 2026 hat feladatán, ezzel átlépte a 29 pontos aranyéremhatárt. A Cline mérése szerint a legjobb futtatás költsége 0,1215…
Így vizsgálnák, hogy biztonságosak-e a chatbotok orvosi tanácsai
Egy igaz állítás is veszélyes lehet, ha egy chatbot nem közli a szükséges figyelmeztetéseket. Az USC ALICE projektje olyan módszereket fejleszt, amelyekkel az orvosi…
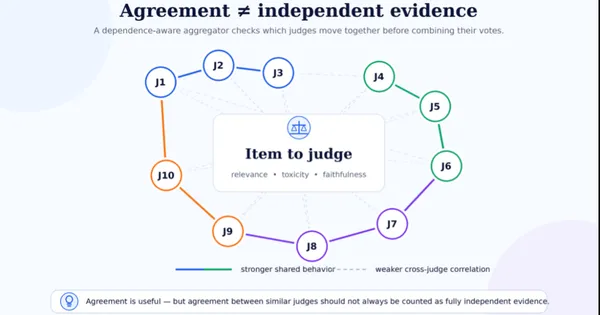
Az LLM-ek egyetértése félrevezető lehet, ha ugyanazt a hibát követik el
Az Amazon kutatói szerint tíz LLM-bíró egybehangzó döntése sem feltétlenül jelent tíz független bizonyítékot. Ising-modellekre épülő módszerük a bírók közötti…
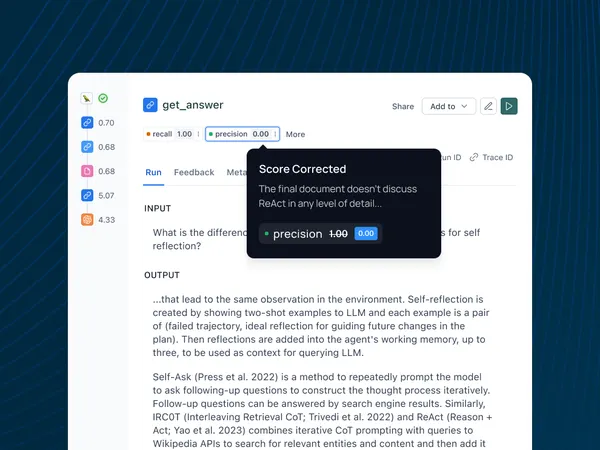
A LangSmith emberi visszajelzésekkel javítja az LLM-bírálókat
A LangSmith új, önfejlesztő értékelési rendszere az emberi javításokat későbbi példaként építi be az LLM-as-a-Judge bírálók működésébe. A LangChain szerint így kevesebb…
A LangChain szerint 2024-ben az AI-ügynökök és a több lépéses munkafolyamatok erősödtek
A LangChain 2024-es jelentése szerint a fejlesztők egyre összetettebb, több lépésből álló LLM-alkalmazásokat építenek, miközben nőtt a nyílt forrású modellek és az…
A LangChain WikiBenchkel méri, mennyire segítik a wikik a kódoló ügynököket
A LangChain elkészítette a WikiBench benchmarkot az OpenWiki által generált kódbázis-dokumentációk értékelésére. A rendszer azt is vizsgálja, hogy a wiki ténylegesen…
A LangChain és az NVIDIA vállalati AI-ügynökplatformot épít
A LangChain és az NVIDIA teljes fejlesztési és üzemeltetési platformot jelentett be vállalati AI-ügynökökhöz. A rendszer a LangSmith, a LangGraph és a Deep Agents…
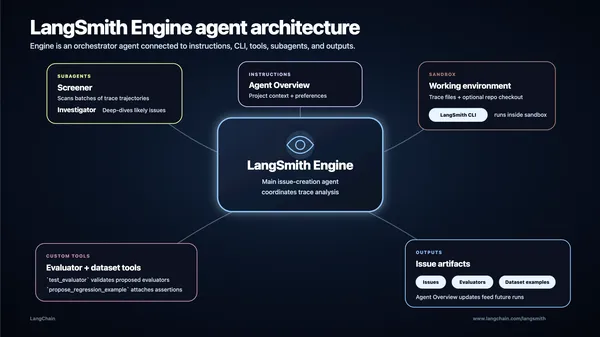
A LangChain ügynököt épített, amely más ügynökök hibáit keresi
A LangSmith Engine a LangChain új ügynöke, amely más ügynökök működési nyomaiból keresi a visszatérő hibákat. A rendszer a problémákat feladatokká alakítja, majd…
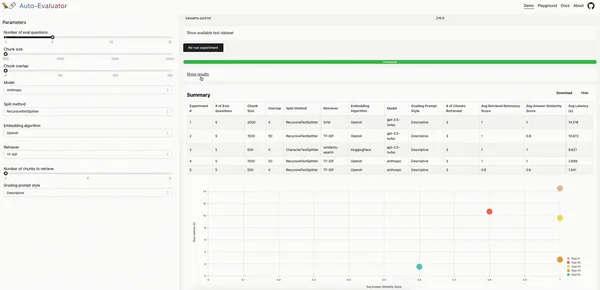
A LangChain nyílt forrású eszközzel teszteli az LLM-es kérdésválaszolást
A LangChain nyílt forrású, ingyenesen használható alkalmazást és API-t tett elérhetővé LLM-alapú kérdésválaszoló rendszerek tesztelésére. Az eszköz dokumentumok alapján…