benchmark
Új módszert javasolnak a különböző látási modellek összevonására
A NAVER LABS Europe olyan feladatalapú közelítő módszert mutatott be, amely felgyorsíthatja a több, különböző látási feladatra finomhangolt modell összehangolását. A…
Az SAP szerint az autonóm bérszámfejtés új szintre emelheti a bizalmat
Az autonóm bérszámfejtés az SAP szerint mesterséges intelligenciával, integrált adatokkal és folyamatos ellenőrzéssel csökkentheti a hibák kockázatát. A vállalat…
A vLLM szerint az ügynöki terhelésekhez új kiszolgálási stratégia kell
Az ügynöki mesterségesintelligencia-terhelések miatt a vLLM a teljes kiszolgálási veremet optimalizálja, a gyorsítótár-kezeléstől a párhuzamosításon át a kérések…
A GitLabon elérhető a GPT-6 Astra, gyorsabban fut és kevesebb tokent használ
Elérhetővé vált a GPT-6 Astra a GitLab Duo Agent Platformon. A GitLab belső tesztje szerint a modell tipikus futása 43,4 százalékkal gyorsabb volt a GPT-5.6 Solénál…
Fable 5.1: olcsóbb lett, de nem minden feladaton
A Fable 5.1 gyorsítótárból történő olvasása 75 százalékkal olcsóbb lett a Fable 5-höz képest, a modell azonban több kimeneti tokent használ. Emiatt az ár attól függ…
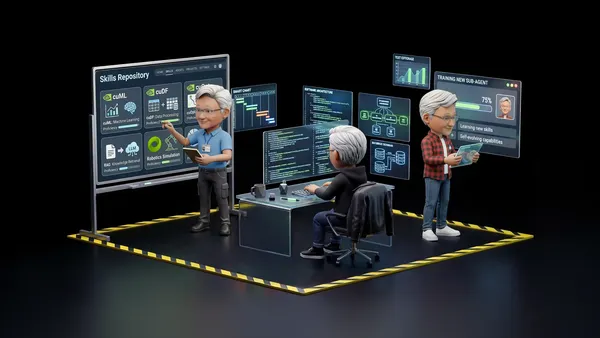
Memóriaalapú vállalati AI-ügynököt mutatott be az NVIDIA NemoClaw-val
Az NVIDIA Developer 2026. szeptember 4-én bemutatta, hogyan épített a vállalat csapata memóriaalapú Chief of Staff ügynököt NVIDIA NemoClaw használatával. A megoldás…
Termékek és eszközökHydraFusion érkezett a GitHub Copilotba, akár 67 százalékkal alacsonyabb költséggel
Satya Nadella, a Microsoft elnök-vezérigazgatója 2026. szeptember 4-én a LinkedInen beszélt a GitHub Copilotban megjelenő HydraFusionről. A Microsoft szerint a megoldás…
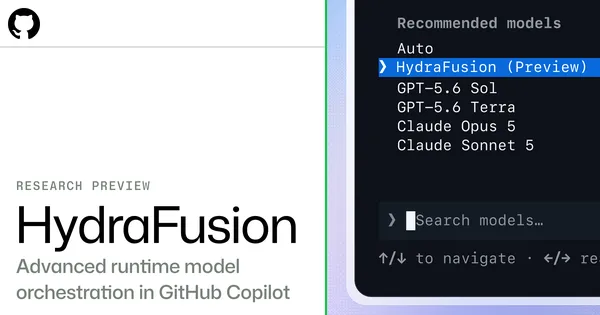
A GitHub bemutatta a Project HydraFusion kutatási előzetesét
A GitHub 2026. szeptember 4-én bemutatta a Project HydraFusion nevű kutatási előzetest. A rendszer a GitHub Copilotban több szolgáltató modelljei közül választ, és futás…
A Microsoft bemutatta a gyorsabb MAI-Image-2.6-Flash képgenerátort
A Microsoft elérhetővé tette fejlesztők számára a MAI-Image-2.6 képgenerátort a Microsoft Foundryban, és bemutatta annak gyorsabb, nagy terhelésre szánt változatát. A…
Az SAP tizenegyedszer lett vezető a Gartner HCM Magic Quadrantjában
Az SAP közlése szerint tizenegyedik egymást követő alkalommal kapott vezetői besorolást a Gartner Magic Quadrant for Cloud HCM Suites for 1,000+ Employee Enterprises…
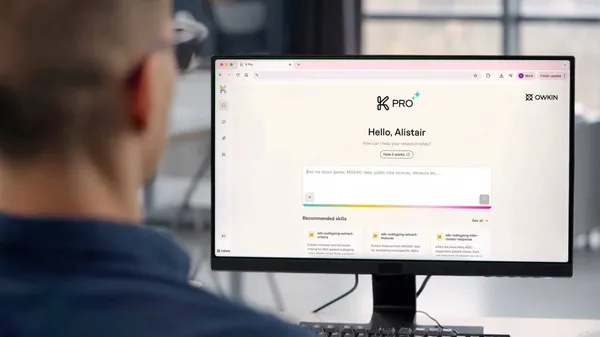
Az Owkin szerint a K Pro megbízhatóbban ismétli meg a biológiai elemzéseket, mint a Claude
Az Owkin összehasonlítása szerint a K Pro ugyanarra a tudományos kérdésre ismételten nagyobb eséllyel elemzi ugyanazokat a betegeket, mint a Claude. A cég szerint ebben…
A CodeRabbit szerint a GPT-6 Astra főleg összetett kódhibákban erős
A CodeRabbit korai értékelése szerint az OpenAI GPT-6 Astra körülbelül 4 százalékkal több címkézett hibát talált megvalósítható javaslatokon keresztül, mint a GPT-5.6…
A Microsoft bemutatta a MAI-Transcribe-2 beszédfelismerő modellt
A Microsoft 2026. szeptember 3-án bemutatta a MAI-Transcribe-2 beszédfelismerő és átíró modellt. A vállalat szerint ez az eddigi legerősebb transzkripciós modellje…
Az új teszten az AI-ügynökök a feladatok 80 százalékát elbukják
A hosszú, több alkalmazáson átívelő számítógépes feladatok továbbra is komoly akadályt jelentenek az AI-ügynököknek. Az OSWorld 2.0 tesztjén a tanulmányban vizsgált…
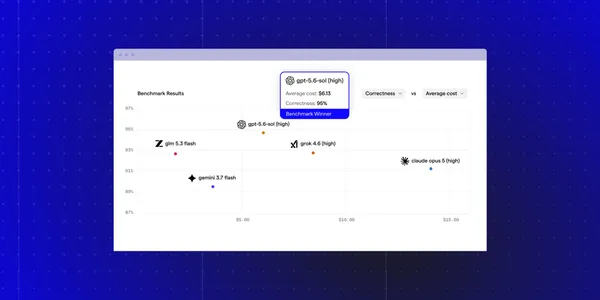
A Warp saját kódolási feladataidon méri le, melyik modell működik a legjobban
A Warp korai hozzáférésben elindította a Benchmarks funkciót, amely a felhasználók saját kódolási feladatain hasonlítja össze a modelleket és az ügynökkonfigurációkat. A…
ModellekAz OpenAI bemutatta a GPT-6 Astrát, új csúcsmodelljét munkára és kódolásra
Az OpenAI 2026. szeptember 3-án bemutatta a GPT-6 Astrát, amelyet a vállalat a világ legintelligensebb és leginkább összehangolt modelljeként ír le. A modell korlátozott…
A GitHub szerint így csökkenthető a Copilot költsége minőségromlás nélkül
A GitHub 2026. szeptember 2-án részletezte, hogyan tette költséghatékonyabbá a GitHub Copilot egyes működési részeit. A vállalat szerint a cél nem az egyes eszközhívások…
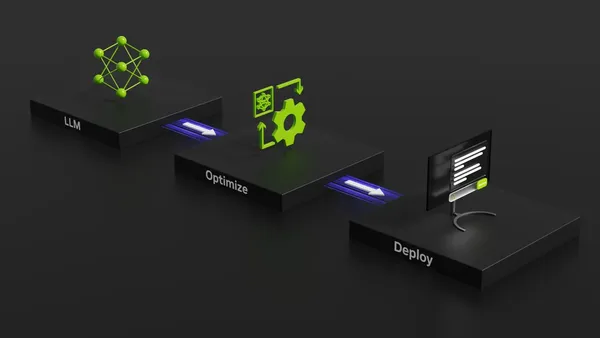
NVIDIA: öt irányelv gyorsíthatja az LLM-ek spekulatív dekódolását
Az NVIDIA Developer 2026. szeptember 2-án közölt technikai útmutatót arról, hogyan gyorsítható az LLM-inferencia spekulatív dekódolással. A bejegyzés öt irányelvet ad a…
A Docker új készlete ismételhetőbbé teszi az AI-értékeléseket
A Docker nyílt forráskódú SBX AI Evaluation Kitje az AI-értékelési munkafolyamatok ismételhető végrehajtását és ellenőrzését segíti. A készlet nem modelleket futtat és…
A Fable 5.1 gyorsabb és takarékosabb, de az Opus 5 megbízhatóbb
A Fable 5.1 a sikeres futások során 58 százalékkal kevesebb kimeneti tokent használt, és 36 százalékkal gyorsabban végzett, mint az Opus 5. A Snorkel AI értékelése…
BenchMIRT címmel jelent meg bejegyzés az LLM-benchmarkokról
A Hugging Face-en 2026. szeptember 1-jén jelent meg a „BenchMIRT: What are LLM benchmarks actually measuring?” című bejegyzés. A cím alapján a cikk központi kérdése az…
Az Everpure FlashBlade//EXA vezeti az MLPerf Storage v3.0 tesztjeit
Az Everpure FlashBlade//EXA minden benyújtott checkpointing és KV cache mérésben első helyen végzett az MLPerf Storage v3.0 zárt divíziójában. A rendszer a legnagyobb…
Chipek és infrastruktúraMegjelent az MLPerf Storage v3.0, már S3-t is mér
Az MLCommons közzétette az MLPerf Storage v3.0 benchmark eredményeit, amelyek az AI-munkafolyamatokhoz használt tárolórendszerek teljesítményét mérik. Az új kiadás két…
10 milliárd dokumentumos vektorkeresési benchmarkot adott ki a Qdrant
A Qdrant kiadta a Qdrant-Fineweb-10B nevű nyilvános adatkészletet, amely 10 milliárd FineWeb-dokumentum vektorágyazásait és 120 ezer lekérdezés pontos eredményeit…