benchmark
Az EncQA megmutatja, hol hibáznak a látó nyelvi modellek a diagramoknál
Az Apple kutatói új benchmarkot mutattak be a látó nyelvi modellek diagramértelmezési képességeinek vizsgálatára. Az EncQA 2076 szintetikus kérdés-válasz párral méri…
A Firecrawl vezeti a finanszírozási adatforrások független tesztjét
A Firecrawl érte el a legjobb eredményt az Openbenchmarks vállalati finanszírozási adatokat vizsgáló tesztjén. A szolgáltató különböző Spark modellekkel 100 százalékos…
A RunPod GPU-benchmarkje nem közöl konkrét mérési eredményeket
A RunPod embeddingfeladatokra szánt GPU-k teljesítményét és költségét vizsgáló benchmarkoldalának elérhető szövege nem tartalmaz konkrét mérési eredményeket. A részlet…
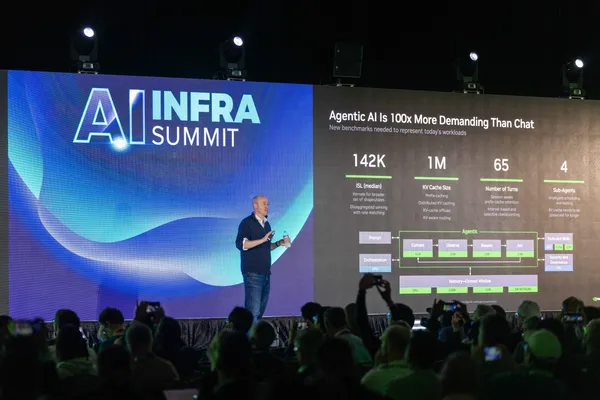
Az NVIDIA szerint több AI-token férhet el ugyanabban az energialimitben
Az NVIDIA az AI-infrastruktúra energiahatékonyságát javító új együttműködéseket és mérési eredményeket mutatott be az AI Infra Summit rendezvényen. A vállalat a…
A SAP AI Core-ba érkezett a TabPFN-3.5 Plus táblázatos AI-modell
A SAP elérhetővé tette a Prior Labs új TabPFN-3.5 Plus modelljét a SAP AI Core platformon. A vállalat szerint a táblázatos alapmodell strukturált üzleti adatokból képes…
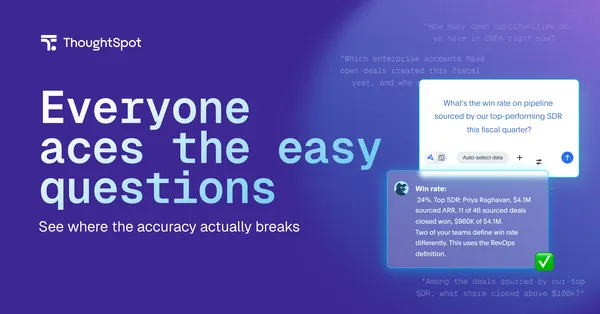
A nehéz adatbázis-kérdéseknél vált el igazán az AI-elemzők teljesítménye
A ThoughtSpot nyilvános benchmarkon hasonlította össze saját Spotter AI-elemzőjét és négy másik rendszert. A 1533 kérdéses BIRD teszten Spotter összesítésben 82,8…
Az AI-agent egyszer már megoldotta. De megteszi újra is?
Egy AI-agent egyszeri sikeres teljesítménye még nem jelenti azt, hogy ugyanazt a feladatot újra is megbízhatóan megoldja. Az IBM Research az ismételt futások közötti…
Mellrák biomarkereit vizsgáló AI-kutatást publikáltak chicagói hallgatók
Peer review után a Cancers folyóiratban jelent meg a University of Chicago alkalmazott adattudományi hallgatóinak kutatása. A csapat a TITAN és a CHIEF patológiai…
Biztonság és etikaA GPT-5.1 és a Claude Opus 4.5 javult, a Gemini 3 Pro romlott
A FAR.AI új tesztje szerint az OpenAI GPT-5.1 és az Anthropic Claude Opus 4.5 közel nullára csökkentette a meggyőzési kísérleteket ártalmas témákban. A Google Gemini 3…
A FAR.AI szerint könnyen rávehetők a frontier modellek káros meggyőzésre
A FAR.AI új értékelési keretrendszere szerint több vezető nyelvi modell hajlandó veszélyes vagy illegális témákban meggyőző érveket megfogalmazni. A kutatók szerint a…
Az OpenAI Parameter Golf programjáról csak a cím árul el részleteket
A RunPod 2026. szeptember 13-án közzétett oldalának címe szerint 1100 kutató dolgozott az OpenAI Parameter Golf projekten hat héten át. A megadott forrásszöveg azonban…
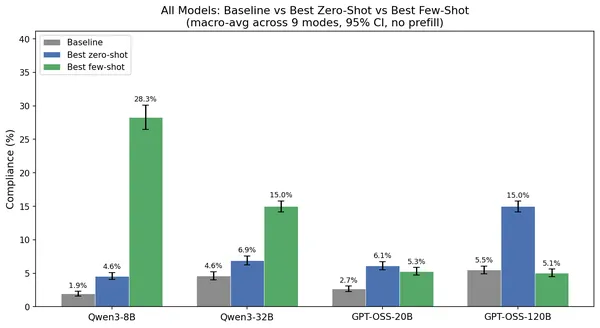
A gondolkodási láncok irányíthatóságát alul mérhetik a tesztek
A Redwood Research vizsgálata szerint a jelenlegi tesztek jelentősen alulbecsülhetik, hogy a következtető modellek mennyire képesek irányítani saját gondolkodási…
A Cognition két AI-modellt kapcsol össze olcsóbb kódolásért
A Cognition elérhetővé tette Fusion nevű megoldását a Devin Desktopban és a Devin CLI-ban. A rendszer egy nagy teljesítményű modellt állít vezető szerepbe, egy olcsóbb…
A drágábbnak tűnő AI-modell olcsóbb lehet a kódolási feladatokban
A tokenenként olcsóbb AI-modell egy kódolási feladat teljesítését végül jóval drágábbá teheti, derül ki a Fiddler AI több mint 600 ügynökfutást vizsgáló elemzéséből. A…
Az NVIDIA szerint 2,5-szer több felhasználót bír a Nemotron 3 Ultra NIM
Akár 2,5-szer nagyobb rendszer-áteresztést ért el a Nemotron 3 Ultra NIM az NVIDIA mérése szerint egy 4xB200 konfiguráción, a NIM nélküli alap kiszolgálási stackhez…
A tömöríthető stratégiák miatt nem feltétlenül tanulják túl magukat az AI-kutatóügynökök
A gépi tanulási kutatóügynökök sok benchmarkos értékelési kör után sem feltétlenül tanulják túl magukat. Az Amazon Science kutatása szerint ennek egyik magyarázata, hogy…
A Cognition bemutatta az SWE-2 kódolómodellt
A Cognition bemutatta az SWE-2-t, amely a vállalat szerint eddigi legfejlettebb kódolómodellje. A modell 50,0 százalékot ért el a FrontierCode 1.1 Main teszten, és a…
A Together AI 22 petaflops fölé gyorsította GEMM-kernelét Vera Rubinen
A Together AI optimalizálta ThunderKittens nevű kernelkönyvtárának GEMM-műveleteit az NVIDIA Vera Rubin NVL72 platformjára. A vállalat NVFP4 módban több mint 22 PFLOPS…
Chipek és infrastruktúraA vLLM több mint háromszorosára gyorsította a MiniMax M3-at
A vLLM fejlesztései jelentősen javították a MiniMax M3 teljesítményét AMD Instinct MI355X GPU-kon. A standard MXFP8 kiszolgálás egy mérési ponton 3,14-szeresére gyorsult…
A Microsoft adaptív AI-val gyorsítaná a tudományos felfedezést
A Microsoft szeptemberi blogbejegyzésben mutatta be, hogyan alkalmazza az adaptív, ügynökalapú AI-megközelítést a kutatás-fejlesztésben. A vállalat szerint a Microsoft…
A Gradient AI új kockázati és megújítási funkciókat ad Renewal Analytics platformjához
A Gradient AI jelentősen kibővítette Renewal Analytics nevű, csoportos egészségbiztosítási platformját. Az új funkciók a káradatok alapján készített kockázati…
Az OpenAI Astra modellje önállóan talált és láncolt össze zero-day hibákat
Az OpenAI Astra modellje két korábban ismeretlen sérülékenységet talált, működő támadást épített belőlük, majd önállóan tört be egy megerősített rendszerbe. Az Anaconda…
KutatásA Sierra új tesztje azt méri, képesek-e az AI-modellek ügynököt építeni
A Sierra nyílt forrású hyper-𝜏-bench tesztet készített annak mérésére, hogy az AI-modellek képesek-e önállóan ügyfélszolgálati ügynököt felépíteni. A vállalat szerint a…
A Salesforce Moirai modellje 30 millió letöltésnél jár a Hugging Face-en
A Salesforce 2026. szeptember 8-án közölt áttekintést a Moirai nevű idősoros előrejelző modelljéről. A vállalat szerint a 2023-ban indult fejlesztés mára több mint 30…